Microservizi con Spring Boot: creiamo due servizi realmente indipendenti
Quando si parla di microservizi, spesso si finisce rapidamente a discutere di Kubernetes, service discovery, API gateway, Kafka, Docker Swarm e altre creature mitologiche che sembrano indispensabili anche quando l'obiettivo iniziale è semplicemente capire come separare due applicazioni. Io preferisco partire dall'altra estremità: prendere un problema piccolo e costruire due servizi che abbiano davvero una propria responsabilità.
Per questo ho realizzato un progetto didattico con Spring Boot composto da due microservizi: user-service e content-service. Il primo gestisce gli utenti e l'autenticazione, il secondo gestisce i contenuti. Sono due applicazioni indipendenti, con due database PostgreSQL separati e senza codice condiviso.
La scelta è voluta. Un'architettura a microservizi non consiste nel prendere una normale applicazione monolitica, dividere le classi in cartelle chiamate user e content e dichiarare vittoria. Se i servizi continuano a dipendere dallo stesso database, dalle stesse entità o da un modulo comune pieno di dipendenze, abbiamo semplicemente spostato il monolite in giro per il progetto.
L'obiettivo del progetto è quindi molto concreto: capire dove passa il confine tra due microservizi, come comunicano, come si gestiscono i database e quali problemi emergono appena smettiamo di avere un'unica applicazione che controlla tutto. Perché i problemi dei microservizi sono molto più interessanti quando smettono di essere diagrammi colorati e iniziano a rompere davvero qualcosa.
Il progetto che vogliamo costruire
Il progetto si chiama spring-services e contiene due applicazioni Spring Boot.
user-service ascolta sulla porta 8181 e gestisce gli utenti e l'autenticazione. content-service ascolta sulla porta 8282 e gestisce i post.
Ogni servizio ha il proprio database PostgreSQL. Il risultato finale è quindi questo:
spring-services
├── user-service      → PostgreSQL: user-db
└── content-service   → PostgreSQL: content-db
Il punto fondamentale è che user-service non possiede il database di content-service e viceversa. Non abbiamo quindi una grande base dati centrale alla quale entrambi accedono liberamente.
Per il progetto utilizziamo Java 21, Spring Boot 4.1.1, Spring Framework 7.0.9, Hibernate 7.4.5, Liquibase 5.0.3 e PostgreSQL 16.
Sono versioni volutamente moderne, perché se sto studiando Spring Boot nel 2026 non ha molto senso costruire tutto intorno a versioni che ormai appartengono al museo archeologico del software.
Creare il progetto con IntelliJ IDEA
Per partire ho utilizzato IntelliJ IDEA e un Maven Archetype Quickstart, invece di affidarmi completamente al generatore di Spring Initializr.
La differenza è interessante perché l'Archetype Quickstart ci permette di partire da una struttura Maven essenziale e costruire manualmente il parent project e i moduli. Per un progetto didattico sui microservizi è utile perché ci costringe a capire cosa sta facendo Maven invece di nascondere tutto dietro una procedura guidata.
Da IntelliJ IDEA creo un nuovo progetto Java utilizzando Maven Archetype e scelgo maven-archetype-quickstart.
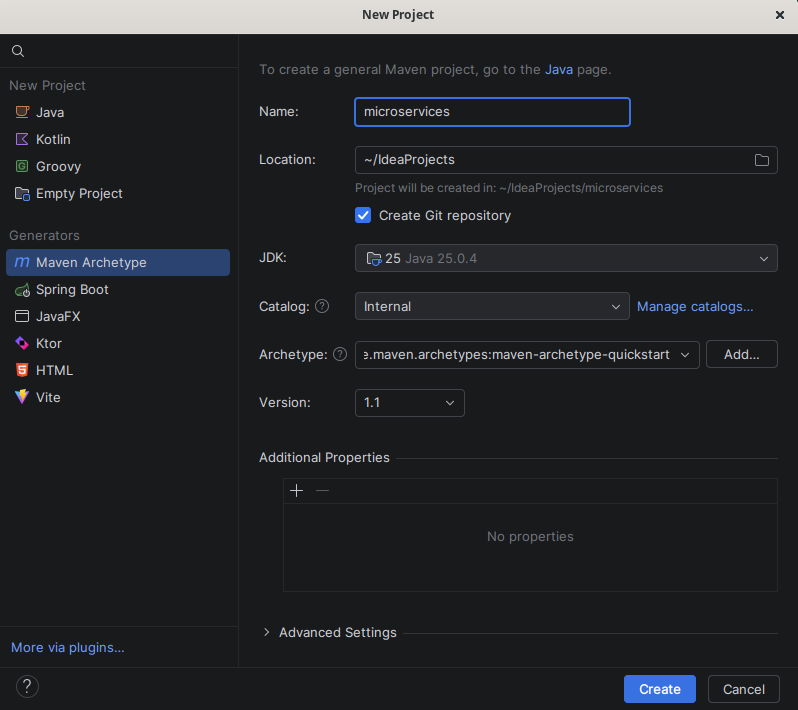
Il progetto principale sarà il parent del nostro sistema:
spring-services/
├── pom.xml
├── user-service/
├── content-service/
└── docker-compose.yml
Il pom.xml principale diventa quindi il punto di coordinamento Maven del progetto. I due microservizi saranno moduli separati, ciascuno con il proprio pom.xml.
Il concetto importante è che parent Maven non significa codice condiviso.
Il parent serve a gestire il progetto dal punto di vista della build, delle versioni e dei moduli. Non deve diventare il posto dove infiliamo classi Java utilizzate da tutti i servizi.
Questa distinzione diventa importante più avanti.
Il parent Maven
Il progetto principale può essere configurato come packaging pom e dichiarare i due moduli:
<packaging>pom</packaging>

<modules>
    <module>user-service</module>
    <module>content-service</module>
</modules>
A questo punto Maven sa che spring-services è un progetto composto da due moduli.
Possiamo quindi lavorare sull'intero progetto con Maven oppure entrare nei singoli servizi.
Per esempio:
mvn clean installoppure avviare direttamente uno dei due:
mvn -pl user-service spring-boot:rune:
mvn -pl content-service spring-boot:runQuesta struttura ci dà anche un vantaggio didattico importante: possiamo vedere chiaramente che stiamo costruendo due applicazioni, non una sola applicazione enorme con due controller.
Creiamo user-service
Il primo servizio è quello che gestisce gli utenti.
La sua responsabilità è semplice: registrare gli utenti, autenticare le credenziali e successivamente emettere i token JWT.
La struttura può essere organizzata in questo modo:
user-service/
└── src/
    └── main/
        ├── java/
        │   └── ...
        │       ├── domain/
        │       ├── repository/
        │       ├── service/
        │       ├── web/
        │       └── config/
        └── resources/
            ├── application.properties
            ├── db/
            │   └── changelog/
            └── keys/
Il dominio contiene l'entità User, il repository si occupa dell'accesso al database, service contiene la logica applicativa, mentre web espone controller e DTO.
Non è una struttura magica e non è obbligatorio organizzare ogni progetto Spring esattamente così. Mi interessa soprattutto che la responsabilità del servizio rimanga chiara.
Creiamo content-service
Il secondo servizio è content-service.
Qui gestiamo i post.
La struttura è analoga:
content-service/
└── src/
    └── main/
        ├── java/
        │   └── ...
        │       ├── domain/
        │       ├── repository/
        │       ├── web/
        │       └── config/
        └── resources/
            ├── application.properties
            └── db/
                └── changelog/
Notiamo una cosa apparentemente banale ma architetturalmente importante: non importiamo l'entità User da user-service.
content-service ha il proprio codice.
Se domani cambiamo la rappresentazione interna dell'utente dentro user-service, non voglio dover ricompilare content-service perché qualcuno ha deciso di rinominare una proprietà Java.
Questo è uno dei motivi per cui nei microservizi bisogna stare molto attenti alla tentazione di creare un modulo common.
Un database per servizio
Adesso arriviamo a uno degli aspetti più importanti dell'esempio.
user-service utilizza user-db.
content-service utilizza content-db.
Possiamo avviare i due PostgreSQL tramite Docker Compose:
services:
  user-db:
    image: postgres:16
    ports:
      - "5433:5432"

  content-db:
    image: postgres:16
    ports:
      - "5434:5432"
Le porte esterne 5433 e 5434 sono semplicemente una scelta pratica per evitare conflitti con eventuali PostgreSQL già presenti sulla macchina.
I servizi Spring continuano a vedere due database distinti.
Questa separazione non è un dettaglio di configurazione. È una decisione architetturale.
Se user-service può fare query direttamente sulle tabelle di content-service, i due servizi non sono realmente indipendenti.
Ed è proprio qui che arriva uno dei problemi più interessanti del progetto.
Perché posts.user_id non è una foreign key
Nel database di content-service abbiamo una tabella posts.
Possiamo avere un campo:
user_id UUIDma non una foreign key verso user-db.users.
La domanda naturale è: perché?
Perché una foreign key è un vincolo che il database può verificare soltanto all'interno del proprio database.
Se posts si trova in content-db e users si trova in user-db, PostgreSQL non può trattare quella relazione come una normale foreign key tra tabelle dello stesso database.
Potremmo naturalmente costruire meccanismi molto più complessi per sincronizzare informazioni, ma sarebbe un altro problema.
La cosa importante è capire il principio: il database appartiene al servizio.
Quindi content-service conosce l'identificativo dell'utente, ma non possiede la tabella degli utenti.
Questo significa anche che non possiamo fare:
SELECT *
FROM posts
JOIN users ON users.id = posts.user_id;
come faremmo tranquillamente in un monolite.
Se vogliamo restituire un post insieme ai dati dell'autore, dobbiamo recuperare le informazioni attraverso il confine tra i servizi e comporre il risultato.
È un costo reale dei microservizi.
Ed è giusto dirlo chiaramente: non stiamo eliminando la complessità. La stiamo spostando.
Liquibase al posto di Hibernate
Per gestire lo schema utilizziamo Liquibase.
Questo significa che la struttura del database non viene lasciata nelle mani di Hibernate.
Hibernate viene configurato con:
spring.jpa.hibernate.ddl-auto=validateIl comportamento è molto diverso da un update.
Con update, Hibernate può tentare di modificare lo schema sulla base delle entità.
Con validate, invece, Hibernate verifica che quello che trova nel database sia compatibile con il modello e, se qualcosa non torna, l'applicazione fallisce in avvio.
Personalmente preferisco questo approccio soprattutto quando il progetto cresce.
Lo schema del database deve essere una cosa che decidiamo e revisioniamo, non qualcosa che compare magicamente perché Hibernate ha avuto un'idea alle tre di notte.
Liquibase ci permette quindi di versionare le modifiche al database insieme al codice.
Gli UUIDv7
Per gli identificativi abbiamo scelto UUIDv7.
Gli ID vengono generati dall'applicazione attraverso Hibernate:
@UuidGenerator(style = UuidGenerator.Style.VERSION_7)La scelta di UUIDv7 è interessante perché mantiene le proprietà di un identificatore non facilmente enumerabile, ma incorpora una componente temporale che rende gli UUID più ordinabili rispetto agli UUID completamente casuali.
Questo è utile soprattutto per gli indici.
C'è però anche un compromesso: l'identificatore contiene informazione temporale.
Quindi UUIDv7 non significa semplicemente "UUID più figo". Come ogni scelta tecnica, porta vantaggi e conseguenze.
Nel nostro caso è una scelta ragionevole per un progetto che deve anche mostrare una soluzione moderna alla generazione degli identificativi distribuiti.
La registrazione
A questo punto possiamo esporre la prima API.
La registrazione avviene su user-service:
POST http://localhost:8181/userscon:
{
  "username": "luca",
  "email": "luca@example.com",
  "password": "secret123"
}
Il servizio restituisce 201 Created.
La risposta non contiene la password.
Username ed email sono unici e un duplicato produce 409 Conflict.
È una piccola API, ma ci permette già di vedere il principio fondamentale: il client parla con il servizio che possiede quella responsabilità.
Non manda una richiesta a content-service per creare un utente e non accede direttamente al database.
Dal client al database
Il percorso della richiesta è quindi:
HTTP
 │
 ▼
UserController
 │
 ▼
DTO
 │
 ▼
Service
 │
 ▼
UserRepository
 │
 ▼
user-db
Questo flusso diventa particolarmente utile quando poi introduciamo l'autenticazione.
Il controller non dovrebbe contenere tutta la logica applicativa e il repository non dovrebbe diventare il posto dove mettiamo qualsiasi cosa perché "tanto funziona".
La separazione serve soprattutto a mantenere leggibile la responsabilità di ogni livello.
Creare un post
Il secondo servizio espone:
POST http://localhost:8282/postsIn questa prima parte possiamo pensare alla richiesta come a:
{
  "title": "Primo post",
  "body": "Scritto da Luca"
}
Il servizio salverà il post nel proprio database.
Ma c'è già una domanda importante: chi è l'autore?
Non vogliamo che il client possa inviare:
{
  "title": "Primo post",
  "body": "Scritto da Luca",
  "userId": "qualcun-altro"
}
Per ora la parte dell'autenticazione la lasciamo al secondo articolo, ma la decisione architetturale è già chiara: l'identità dell'utente deve arrivare da un meccanismo affidabile di autenticazione, non da un campo arbitrario inviato dal browser.
Avviare tutto
Con Docker avviamo i database:
docker compose up -dPoi avviamo i due servizi separatamente:
mvn -pl user-service spring-boot:rune:
mvn -pl content-service spring-boot:runA questo punto abbiamo due processi Spring Boot indipendenti.
user-service è disponibile sulla porta 8181.
content-service è disponibile sulla porta 8282.
La cosa interessante è che possiamo fermare uno dei due servizi senza che l'altro smetta necessariamente di esistere.
Questo sembra banale, ma è proprio il punto: abbiamo creato confini di esecuzione distinti.
La tentazione del modulo common
Una delle prime tentazioni che ho voluto evitare è creare un modulo:
common/e metterci dentro:
User.java
UserDto.java
SecurityUtils.java
SomeService.java
all'inizio sembra comodissimo.
Poi arriva il giorno in cui user-service vuole modificare User, content-service dipende da quella classe, il modulo comune acquisisce una dipendenza, quella dipendenza ne introduce un'altra e improvvisamente abbiamo ricostruito un monolite con Maven che distribuisce il dolore su più directory.
Non significa che condividere codice sia sempre tecnicamente sbagliato.
Significa che condividere codice tra microservizi crea un accoppiamento.
Nel nostro progetto preferiamo che attraversi il confine un dato, non una classe Java.
Per esempio:
user-service
       │
       │ UUID
       ▼
content-service
e non:
user-service
       │
       │ User.java
       ▼
content-service
È una differenza enorme.
Cosa abbiamo realmente ottenuto
A questo punto il progetto è ancora piccolo.
Non abbiamo Kafka, non abbiamo Kubernetes, non abbiamo un API Gateway, non abbiamo service discovery e non abbiamo bisogno di 47 container per salvare un post.
Abbiamo però qualcosa di più importante per imparare: un confine reale.
Abbiamo un servizio che possiede gli utenti e un servizio che possiede i contenuti.
Abbiamo due database.
Abbiamo due processi.
Abbiamo due configurazioni.
Abbiamo due modelli di dominio.
E soprattutto abbiamo accettato che alcune operazioni che in un monolite erano banali, come una JOIN tra utenti e post, adesso richiedono una comunicazione tra servizi.
Questa è la vera introduzione ai microservizi.
I problemi che abbiamo volutamente lasciato aperti
Il progetto non vuole fingere di essere pronto per la produzione.
La chiave privata RSA utilizzata dall'autenticazione è ancora gestita all'interno delle risorse del progetto e in un ambiente reale dovrebbe essere fornita attraverso un sistema di gestione dei secret. Le password dei database sono presenti nella configurazione e dovrebbero essere sostituite da variabili d'ambiente o da un secret manager.
Abbiamo inoltre un problema interessante con createdAt: il database può valorizzare il campo attraverso now(), ma l'entità Java che Hibernate ha appena persistito non viene automaticamente riletta. Di conseguenza possiamo avere una risposta JSON con createdAt: null mentre nella tabella il valore esiste correttamente.
Sono problemi piccoli, ma sono proprio questi problemi che rendono un progetto didattico utile. Un esempio perfettamente pulito non insegna quasi nulla su cosa succede quando le cose smettono di essere perfette.
Manca anche una suite di test di integrazione. Il test più interessante da aggiungere sarà quello che farà comunicare realmente i due servizi: user-service firma un token e content-service deve essere in grado di verificarlo.
Ed è proprio da qui che parte il secondo articolo.
Nel prossimo passaggio non ci basta più sapere che esistono due servizi. Dobbiamo risolvere il problema dell'identità: come può content-service fidarsi dell'utente autenticato da user-service senza conoscere le sue credenziali e senza condividere un segreto che permetterebbe anche di falsificare i token?
La risposta sarà JWT firmato con RSA e distribuito attraverso JWKS.